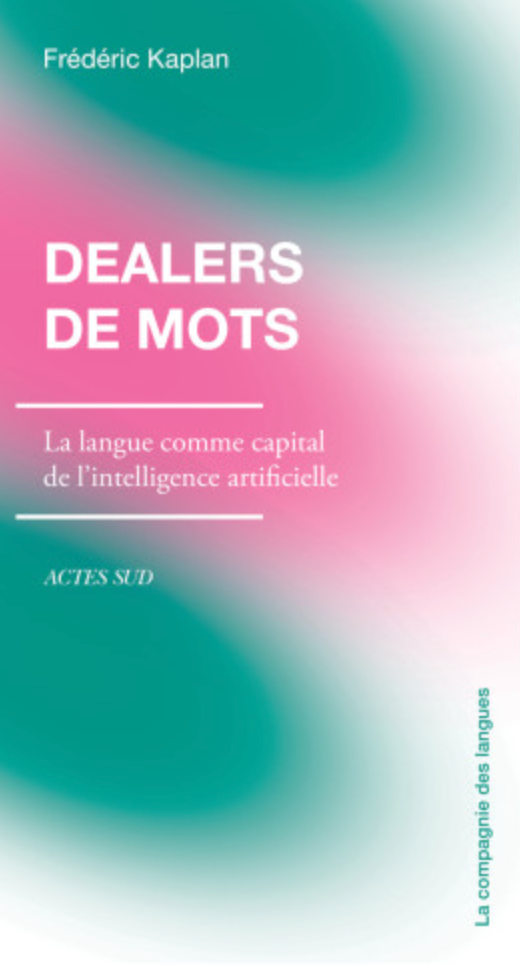
Dans un article du Monde Diplomatique de novembre 2011, le chercheur Frédéric Kaplan avait introduit la riche notion de « capitalisme linguistique ». Dans un petit livre pour Actes Sud, Dealers de mots, il revisite son concept à l’heure de l’IA générative pour souligner combien la fortune du capitalisme linguistique est plus totale qu’elle ne l’était quand Google inventait son Page rank, son algorithme de classement des résultats de recherche. Parier sur les mots a permis à Google de bâtir son empire et désormais bâtit ceux des producteurs d’IA. La langue est plus que jamais le pouvoir et certains l’accaparent au risque de nous en déposséder.
A l’heure où nous faisons nôtres les mots produits par des machines ou plutôt à l’heure où nous louons à d’autres nos capacités d’expression, l’usage de « prothèses linguistiques » nous exproprie toujours plus de notre propre parole. Tous nos discours ont été accaparés par quelques entreprises se forgeant un capital qu’elles n’ont plus qu’à nous revendre.
Dans son livre, le chercheur raconte l’évolution du capitalisme linguistique comme un roman, avec beaucoup de clarté, d’une manière très accessible. Une histoire que Google s’est longtemps accaparé, la firme transformant le classement des pages par les mots puis réinventant leur modèle économique par la publicité avec Adwords. « Tout ce qui peut être nommé peut donner lieu à une enchère ». Et l’immense capital accumulé par Google provient tout entier de ce marché : celui de la vente des mots. La somme des données linguistiques accumulées est devenue l’un des capitaux moteurs du capitalisme technologique. La plus value désormais consiste à découpler totalement la valeur économique des textes écrits du travail nécessaire pour les produire. C’est-à-dire de les réexploiter sans avoir à les payer : leur donner une nouvelle existence économique pour leur faire produire de nouvelles valeurs encore. Un capitalisme visant à exploiter la connaissance sous toutes ses formes, comme un raffinage nouveau d’une première extraction afin de produire non seulement de la connaissance mais plus encore des machines à connaissance. « Chaque année, Google gagne des centaines de milliards de dollars simplement en organisant la vente des mots à l’échelle planétaire » (493 millions de dollars par jour de chiffre d’affaires en 2020). Kaplan explique que le capital linguistique n’est rien d’autre que la somme des données linguistiques accumulées par un acteur. Ce capital résulte de l’extraction de textes existants et consiste à les accumuler pour les valoriser sous formes de services. Il consiste à capter, « idéalement sans les payer, ces écritures productives de valeur ». Ce nouveau territoire d’exploitation à l’avantage d’être peu balisé et peu réglementé, hormis par la propriété intellectuelle dont il exploite les failles.
Pour Kaplan, le modèle économique de Google ne repose pas tant sur une économie de l’attention, que sur une économie de l’expression, c’est-à-dire d’être un médiateur de l’écrit. Le but est bien plus d’optimiser l’efficacité de l’écrit, d’optimiser l’écriture, d’infléchir les productions à son profit et au profit de ses outils et services. Google nous corrige parce que les mots sont exploitables, à l’image des systèmes d’autocomplétion. Les corrections sont orientées « selon la valeur économique donnée par le marché aux expressions produites ». Nous écrivons via les outils de Google et Google peut exploiter chaque mouvement des productions langagières. Et la vente des mots se faisant sans effort, Google dégage des profits lui permettant de produire des projets sans contrainte de rentabilité.
Google ne fait pas qu’intercepter les flux de discours, il s’est également lancé dans des opérations d’extraction langagière, comme Google Books, qui a permis de numériser plus de 40 millions de livres, rappelle Kaplan, « l’équivalent de 820 millions d’années de travail ». Là, encore, Google a fait grandir son capital épistémique, accumulant « métaphores, personnages, concepts, faits ». Le lancement de ChatGPT en novembre 2022 a produit une nouvelle démonstration de la valeur qui pouvait être extraite de ce capital linguistique, dont la plupart des technologies sous-jacentes ont été produites par les équipes de Google (notamment la technologie Transformer). Le chercheur, rappelle d’ailleurs, avec une grande pédagogie, combien l’invention de cette linguistique plate, statistique, probabiliste, n’est pas autre chose que la continuité de l’approche que Google a appliqué avec Page Rank et Adwords. Désormais, la valeur du capital linguistique repose sur « la longueur cumulée de toutes les séquences de tokens auxquelles un acteur à un accès exclusif », car c’est ce capital même qui va permettre d’ajuster les paramètres des systèmes d’IA, de les ajuster depuis « la table de mixage du Transformer ». Dans cette reconfiguration, « seules comptent les performances de calcul des réseaux et la taille des données d’entraînement ». La performance des systèmes n’est qu’une question de puissance, de volume, d’argent. La puissance, la force brute, les volumes d’investissements… sont devenus les seuls enjeux et consistent à prendre le contrôle d’un marché depuis des logiques de pertes assumées.
OpenAI ne disposait pourtant pas du capital linguistique de Google. Pour résoudre cette difficulté, il a fait ce que Google avait fait avant lui : moissonner l’ensemble du web, comme l’a montré l’enquête du Washington Post. Dans ce moissonnage, tout l’enjeu est de qualifier les données pour donner plus de poids à certains contenus plutôt qu’à d’autres, notamment aux contenus issus de la presse. Dans la course au capital linguistique, désormais, les acteurs tentent de trouver des ressources exclusives permettant d’affiner leurs modèles pour produire d’innombrables « simulateurs de discours ». Mais plus encore désormais les différences tiennent bien plus dans les paramètrages, les phases d’entraînement et de renforcement. Pour Kaplan, les guerres du capitalisme linguistique risquent surtout de refermer les projets d’ouverture de la science. « Si le capital linguistique devient une ressource précieuse, liée à une forme de souveraineté linguistique nationale, il peut paraître irresponsable de l’offrir librement à n’importe quel acteur. Les grandes entreprises de l’intelligence artificielle l’ont compris depuis plusieurs années déjà : les corpus les plus stratégiques pour l’entraînement des modèles de langage ne sont jamais rendus publics ».
Le risque de l’atrophie linguistique
Nous sommes désormais enjoints à vivre avec les simulateurs de discours. Et cela n’est pas sans conséquences. Dans tous les domaines où le texte est moteur, les crises sont là : journalisme, éducation, droit… En exploitant la langue, c’est elle-même qui est transformée et en ré-exploitant les textes, c’est leur condition de production largement artisanale qui est menacée. L’économie du texte construit sur la difficulté à écrire est d’un coup bouleversée par les modèles de langage. En sciences, cela conduit par exemple à l’effondrement des modèles d’évaluation. A l’école, cela conduit à interroger le sens même de l’apprentissage. Tout notre édifice épistémique, construit sur les performances rédactionnelles, vacille, sous les coups du développement du capitalisme linguistique. Partout, les machines qui écrivent réévaluent la valeur du travail d’écriture dans les structures de management. Du code au droit, des contrats aux instructions, de l’information aux textes instrumentaux (compte rendu, demandes de rendez-vous, courriers administratifs…), c’est la pertinence même des processus bureaucratiques qui est remise en question. « Ecrire avec la machine à écrire de quelqu’un d’autre, c’est prendre le risque de se voir voler son texte ». Mais plus encore d’en être non seulement dépossédé, quand ce n’est pas remplacé par les productions automatisées. Derrière ces enjeux épistémiques, c’est l’épistémologie elle-même qui est remise en question. « L’écriture algorithmique change notre confiance dans l’écrit », explique Kaplan. Mais c’est désormais à chacun d’entre nous de gérer cela, dans une relation d’autant plus difficile que ces textes sont construits pour « cacher la nature des procédés qui les ont engendrés ».
Pour le professeur en Humanités numériques, nous sommes confrontés désormais à notre prolétarisation linguistique. Nous sommes désormais invités à payer pour écrire tant de mots (tokens) par mois, avec des prothèses plus ou moins sophistiquées, plus ou moins chères. L’usage de la langue n’est plus vendu seulement aux annonceurs, mais elle est désormais revendue à chacun d’entre nous. Les prothèses linguistiques sont partout. Elles interviennent dans la production, l’interprétation, la transmission. Elles améliorent l’efficacité, la précision ou la qualité ou la dénaturent. Nous déléguons nos compétences au risque de les abandonner, au risque de transformer profondément nos propres savoir-faire, comme le souligne très bien la philosophe Anne Alombert dans ses travaux, notamment son dernier livre, De la bêtise artificielle. Avec ces prothèses, le risque d’une atrophie de nos compétences semble plus certaine que celui d’un élargissement des compétences linguistiques du plus grand nombre. « Chaque fois qu’une technique prend en charge une faculté humaine, elle en accroît la puissance tout en affaiblissant la maîtrise (…). Les prothèses qui étendent notre intelligence risquent aussi de nous en déposséder si nous ne réinventons pas sans cesse notre façon de penser et d’agir avec elles ». Pour Kaplan, le risque d’une « atrophie expressive », d’une incapacité à composer un discours sans intermédiation est devant nous. « Le locuteur est devenu un locataire ». Nous écrivons et parlons par l’intermédiaire de mots que nous louons à ceux qui possèdent les machines.
Le capitalisme linguistique dévore le monde
Pour Kaplan, même si nous ne nous y sommes pas encore habitué, ce capitalisme linguistique là est pourtant peut-être déjà derrière nous !
Dans le premier régime du capitalisme linguistique, on a revendu les mots aux annonceurs. Dans le second, on peut désormais revendre les mots aux utilisateurs. Dans le troisième, les simulateurs linguistiques peuvent désormais construire, agir, décider. Depuis quelques instructions, les systèmes construisent des systèmes. « Dans le premier régime, les mots qui s’accumulent de façon exponentielle permettent l’organisation d’une bourse qui se globalise à l’échelle mondiale et peut générer des centaines de milliards de dollars de revenus. Dans le deuxième régime, les avancées des modèles de langage prédictifs rendent possibles des prothèses linguistiques d’une expressivité croissante, favorisant l’élargissement des parts de marché et l’accumulation accélérée de capital linguistique supplémentaire. Enfin, dans le troisième régime, l’augmentation conjointe des capacités de calcul et des volumes de données permet de produire des modèles capables de simuler des raisonnements plus complexes ou de résoudre des tâches plus difficiles, sans qu’il soit nécessaire d’apporter des changements significatifs à la nature des architectures informatiques. Il suffit d’investir davantage dans les centres de calcul pour bénéficier de cette augmentation des performances cognitives des modèles. » Avec l’arrivée de « l’autocatalyse cognitive », le capital linguistique croit alors de façon quasi automatique. L’IA agentique promet désormais la grande orchestration des systèmes entre eux et la production d’agents à la carte, facturés selon leur degré d’expertise. « Cette mise au travail du capital linguistique ne se déploie pas comme une superintelligence omnisciente, mais comme une force d’engendrement qui tire sa puissance des boucles de rétroaction dans lesquelles elle s’inscrit. » « Nous sommes en train de passer d’un savoir hérité des communautés humaines à un savoir auto-entretenu par les modèles ». Pour Kaplan, ce sont nos systèmes culturels mêmes qui sont en train d’être transformés, de changer d’état, de phase. Le risque, conclut le chercheur, c’est de basculer dans un quatrième régime du capitalisme linguistique : celui du contrôle de la production du discours et de la langue elle-même. Une forme de convergence des discours, une homogénéisation voire un aplatissement de la langue, structurant une lecture du monde unique. Une logique proche de la novlangue imaginée par George Orwell : « une langue conçue pour limiter la liberté de pensée et d’expression, par l’introduction progressive de contradictions internes. La guerre, c’est la paix ; la liberté, c’est l’esclavage ; l’ignorance, c’est la force ». Mais est-ce les machines qui nous conduisent à cette impasse ? Cette langue est aujourd’hui celle des discours les plus confus et elle n’est pas tant produite par les machines que par les hommes et les idéologies qu’ils activent.
Ce qui est sûr, c’est que le glissement culturel a commencé. En avril 2025, le trafic de Wikipédia, de Youtube, de Facebook et Google a commencé à baisser, alors que celui de l’IA, partout, explose. « L’attention se détourne des contenus construits, discutés et sourcés, pour s’orienter vers des savoirs instantanés et contextualisés ». Le document disparaît. Il est désormais recomposé à la volée. « Le quatrième régime du capitalisme linguistique confère un pouvoir démesuré à ceux qui contrôlent les modèles ». Kaplan plaide certes pour une reprise en main pour construire des corpus et des modèles publics, des modèles à code et paramètres ouverts. Nous devons garder la main sur les forces de production du langage, « avant que n’ayons peut-être plus les mots pour imaginer comment faire ». Le constat qui s’annonce est d’autant plus sombre que la puissance des outils tourne la tête de tous.
Si l’essai de Frédéric Kaplan manque souvent de perspective critique, notamment sur les errements que ces systèmes produisent où sur les gens que ces systèmes exploitent, sa force réside surtout dans sa clarté et dans l’éclairage que produisent les concepts. Reste que si face au capitalisme de surveillance, on pouvait encore réclamer ou opposer une exigence d’une moindre surveillance. Face au capitalisme qui exploite nos propres mots pour nous en déposséder, on ne sait plus quels leviers adresser pour le contenir voire le faire refluer. Face à l’exploitation de notre propre pensée, c’est assurément nous-mêmes qui en seront dépossédés.
Hubert Guillaud