
L’AI Now Institute en collaboration avec Airwars.org, un site qui depuis 2014 documente les conflits, ont publié un excellent reportage visuel pour comprendre les enjeux de l’IA sur le champ de bataille sous forme d’un récit, fictif et simplifié, d’une attaque menée avec l’IA, augmenté d’explications spécifiques. « Pour démystifier l’IA militaire, nous construisons une chaîne de destruction abstraite qui reflète un cycle de ciblage par IA. Plutôt que de copier un cadre formel de chaîne de destruction utilisé par un État spécifique, notre schéma illustre les activités tactiques et les décisions impliquant l’utilisation de systèmes d’IA à travers six étapes : 1. Capteurs et données, 2. Surveillance, 3. Renseignement et identification, 4. Sélection, 5. Frappe et 6. Évaluation post-frappe. »
« Les systèmes d’aide à la décision assistés par l’IA – qu’ils s’appuient sur de grands modèles de langage (LLM) ou sur d’autres types d’algorithmes d’apprentissage automatique – intègrent des informations provenant de capteurs couvrant les zones d’opérations militaires. Il peut s’agir de textes issus d’Internet, d’images satellites, de données audio provenant de télécommunications ou de vidéos captées par des drones. Ces données sont synthétisées sur une interface unique et conviviale.
Le problème : les données des capteurs peuvent être incomplètes ou altérées en raison de défaillances, d’interruptions des communications ou d’incertitudes environnementales. Des données comportant des erreurs d’étiquetage (par exemple, des inversions, des omissions ou des étiquettes superflues) peuvent entraîner une dégradation significative, bien que difficile à déceler, des performances de l’IA. L’écosystème d’information dans lequel évoluent les LLM ou autres réseaux de neurones peut également contenir des informations obsolètes ou délibérément corrompues. Ces sources de données sont par ailleurs vulnérables aux afflux massifs d’événements, aux campagnes de désinformation, au détournement de tendances et aux manœuvres de leurre militaire, autant d’éléments qui finissent par compromettre l’efficacité des technologies d’IA en matière de ciblage. » En fait, contrairement au discours qui voudrait que toutes les données utilisées soient parfaitement fiables, c’est en fait assez peu le cas, rappellent les chercheurs.
Si l’histoire est fictive, les technologies décrites, elles, sont bien réelles. Et les explications permettent de comprendre les enjeux de chacune, comme la détection d’anomalie par exemple, qui vise à repérer des schémas inhabituels ou des changements dans l’imagerie satellitaire, les données radar et autres flux de télédétection provenant de zones d’opérations militaires. Ces systèmes peuvent recourir à des réseaux de neurones à convolution ou à des auto-encodeurs pour traiter des volumes massifs de données et repérer des éléments susceptibles d’indiquer des mouvements de troupes, des déploiements de missiles, des infrastructures endommagées ou des modifications inattendues du terrain. Le problème avec ces technologies de détection d’anomalies c’est qu’elles peinent à distinguer des menaces réelles des variations environnementales ordinaires. « Les conditions météorologiques, les ombres, le bruit des capteurs et les différences d’angles de vue peuvent entraîner des erreurs de classification. De même, les auto-encodeurs sont entraînés à différencier les schémas correspondant à une classification spécifique des anomalies qui s’en écartent. Toutefois, ces modèles manquent de généralisabilité et de fiabilité ; par ailleurs, les données utilisées pour leur apprentissage peuvent être biaisées, présenter une distribution limitée ou reposer sur des classifications stéréotypées, conduisant à une mauvaise identification de la nature ou de l’identité d’une menace imminente. En 2025 par exemple, il a été démontré que la précision de Maven peut chuter en dessous de 30 % lorsqu’il est déployé sur un terrain inconnu ou dans des conditions environnementales incertaines entravant sa capacité à reconnaître et à signaler des objets », comme le rappelait Katrina Manson dans son livre.
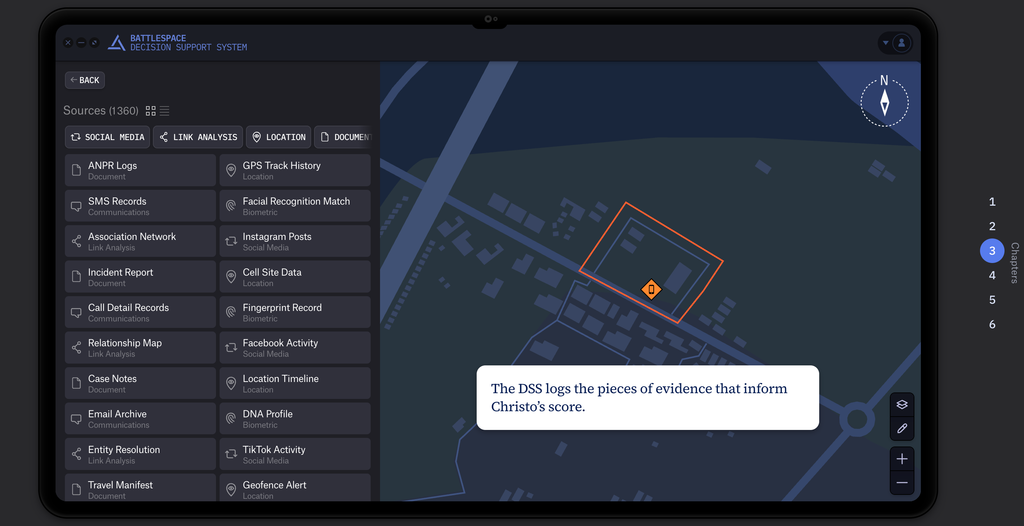
Parmi les nombreuses techniques utilisées, il y a aussi le géorepérage de ces mêmes cibles pour détecter les véhicules ou téléphones qui entrent dans une zone, déclenchant une surveillance et un suivi de la localisation des téléphones et véhicules et une interception des communications : les messages sont automatiquement relayés et traduits en direct, avec des termes qui déclenchent des alertes renforcées (notamment des termes temporels, comme « imminent » ou « bientôt »). Les propriétaires des cartes Sim sont bien sûr identifiés pour contrôler s’ils ne sont pas déjà sur des listes de suspects ou contrôler leur score de risque (un système de notation sociale qui passe au crible toutes les données collectées passivement sur les habitants, données issues de caméras et des réseaux sociaux, pour créer un score de probabilité qu’ils appartiennent à l’armée adverse, voir notre dossier). Si le score de menace est élevé, l’opérateur peut accéder aux sources afférentes pour enquêter et confirmer ou infirmer la menace depuis toutes les données collectées. Parmi celles-ci : les déplacements provenant du GPS du téléphone, les informations relatives aux plaques minéralogiques du propriétaires du véhicules (et donc les déplacements associés à ces véhicules), ses SMS, l’enregistrement de ses derniers appels, l’enregistrement de son visage ou de ses empreintes pour débloquer son téléphone, ses mails, savoir s’il s’est déjà trouvé dans une zone géorepérée… Des tonnes d’informations que l’opérateur n’a souvent pas le temps d’examiner car son temps est compté. Mais surtout, les liens et les activités sur les réseaux sociaux constituent l’un des facteurs du score de risque. Une analyse des publications est produite, traduite et analysée automatiquement notamment pour y détecter des émotions, comme le fait que leur auteur soit susceptible d’apprécier des actions de l’ennemi, ou que ces échanges aient été likés par des membres avérés de l’armée adverse. Dans ces analyses traduites, automatisées, il est impossible de vérifier si les publications en question sont bien réelles ou si les traductions sont fidèles. Ses relations sur les réseaux sociaux ou via ses appels et SMS sont également analysées pour montrer si ses abonnés sont membres de l’armée adverse ou s’il a pu échanger avec des ennemis confirmés. En accédant à son profil, on peut récupérer des photos permettant de lancer automatiquement une requête dans les réseaux de caméras de vidéosurveillance et observer si ses déplacements ont un rapport avec des sites surveillés et sensibles. Là encore les erreurs d’identification peuvent être innombrables. Compte tenu du temps limité, l’opérateur a tendance à valider ce que le système de notation sociale suggère. Si l’identification a un caractère d’urgence, un drone de surveillance peut être déployé pour suivre la personne identifiée.
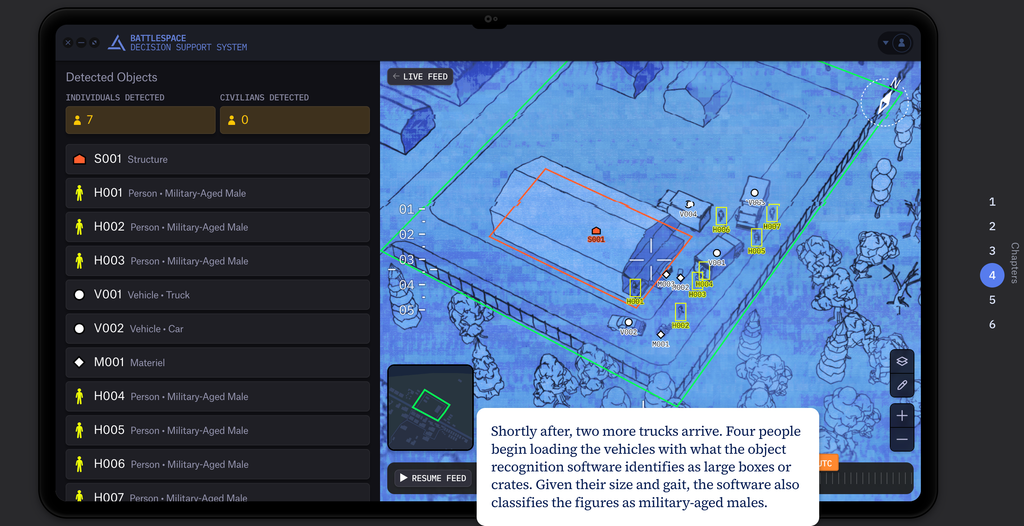
Dans ce cas, le flux vidéo permet d’identifier qui est présent. Les personnes, les véhicules… et les personnes sont distinguées entre civils et membres de l’armée ennemie. Selon leur taille ou leur gabarit, il identifie les objets et les personnes, par exemple en les classant comme des « hommes en âge de combattre ». Chaque image du scénario permet d’accéder à des fenêtres contextuelles permettant de mettre en perspective la fiabilité des technologies utilisées. Par exemple, l’animation rappelle que la détection de formes et d’objets reste peu fiable. « Des recherches ont par exemple révélé que les systèmes peuvent classer de manière erronée 97 % des objets s’ils apparaissent dans des postures s’écartant de celles figurant dans les données d’apprentissage. Par ailleurs, diverses études montrent qu’une grande précision lors des phases de test ne garantit pas nécessairement une précision ou des performances élevées lors du déploiement en conditions réelles. En 2021, l’US Air Force a mené un programme pilote de reconnaissance de cibles affichant un taux de précision de 95 % dans des scénarios d’entraînement. Ce chiffre a toutefois chuté à seulement 25 % en environnement réel. Dans la grande majorité des cas, des algorithmes entraînés à reconnaître des images de missiles sol-sol sous un angle oblique se sont révélés incapables d’identifier ces mêmes objets lorsqu’ils apparaissaient dans des positions différentes. »
Une fois la frappe accomplie, l’opérateur reçoit un rapport d’évaluation, généré par un système d’évaluation des dommages de combat assisté par IA. Ces rapports ont tendance à renforcer les erreurs de classification déjà commises par les systèmes. Les réseaux sociaux sur place et les publications journalistiques locales donnent souvent une autre vision de ces résultats, mais ces informations ne sont pas réintégrées dans le système pour apprécier ses erreurs. Ils montrent aussi parfois que les personnes ciblées ne sont pas aussi menaçantes qu’elles semblaient l’être, en rappelant leur parcours et leurs fonctions.
« À Gaza, l’armée israélienne a publié une vidéo d’une frappe tuant un homme qui transportait ce qu’elle a identifié comme un lance-roquettes. Elle a par la suite reconnu que ses forces avaient mal identifié l’objet : il s’agissait d’un vélo. » La vidéo est d’ailleurs confondante. Vue de haut, on ne sait pas ce que l’homme tient à son bras. Mais, si le système vous indique que c’est un lance-roquette, alors assurément, cela semble en être un. En fait, on comprend que c’est la manière dont ces outils regardent le monde qui est problématique. Pour un système de ce type, tout est menace, tout est orienté pour détecter des menaces, et à force de regarder le monde comme une menace, il le devient.
« Les partisans de l’IA soutiennent qu’elle peut atténuer et réduire ces erreurs. Toutefois, ces systèmes risquent aussi de provoquer l’effet inverse, notamment en augmentant les taux d’erreur tout au long de la chaîne de ciblage et de frappe. Au cours d’une campagne de frappes de 40 jours contre l’Iran ce printemps, l’armée américaine a déclaré avoir atteint plus de 13 000 cibles, un rythme d’opérations quasi impossible à tenir avant l’avènement de l’IA.
L’IA pourrait également compliquer l’identification des défaillances et entraver l’obligation de rendre des comptes. À la suite d’une enquête d’Airwars sur une série de frappes assistées par l’IA ayant tué un étudiant irakien, l’armée américaine a déclaré n’avoir « aucun moyen de savoir » si la frappe meurtrière avait reposé sur l’IA.
Le livre Project Maven (voire notre critique), consacré à l’IA militaire américaine a révélé que, dans certaines opérations, seules deux des six étapes de la chaîne de ciblage et de frappe impliquent désormais une intervention humaine directe, une troisième nécessitant une certaine supervision humaine. Les autres étapes sont aujourd’hui entièrement automatisées. »
Dans une interview pour Democracy Now, Heidy Khlaaf, directrice scientifique chargée de l’IA à l’AI Now Institute et responsable de la publication avec AIrwars de cette fiction explicative, rappelle que derrière ces systèmes automatisés il n’y a pas de robot tueur, mais des chaînes de systèmes algorithmiques qui ont tous leurs propres pièges et leurs propres défauts. « Ils présentent tous une fiabilité et une précision très faibles. Ces systèmes s’appuient les uns sur les autres et s’alimentent mutuellement pour aboutir, malheureusement, à des pertes civiles, comme nous l’avons souvent constaté lors de leur utilisation. » « La distinction entre systèmes autonomes et systèmes de soutien est assez superficielle en pratique ». En réalité, quand on utilise ces systèmes, les biais d’automatisation sont très forts, rappelle-t-elle : tout y est présenté comme un risque. C’est le cas par exemple des systèmes de traduction automatisés, comme l’a montré une enquête d’Associated Press, qui montrait que l’usage de systèmes de traduction avaient du mal avec l’arabe. Prendre un mot pour un autre peut suffire pour vous inscrire sur une liste de personnes cibles. « Il est très difficile de comprendre pourquoi une IA a pris une décision donnée lorsqu’il s’agit de grands modèles de langage, en raison de leur envergure et de leur mode de fonctionnement. Était-ce dû à des données erronées ? L’IA a-t-elle reçu des instructions en ce sens ? S’agissait-il d’hallucinations ? Quiconque a utilisé ChatGPT sait que ces agents conversationnels inventent souvent des informations. C’est, je pense, la situation dans laquelle nous nous trouvons actuellement. La cause exacte de ces événements reste incertaine. En fait, je dirais même que c’est là l’une des finalités des systèmes d’IA : ils servent souvent à diluer la responsabilité », comme le pointait très bien le sociologue Ori Schwarz également (voir notre article).
« En fin de compte, ces entreprises sont en train de réinventer la notion de sécurité. Elles s’approprient bon nombre de termes traditionnellement utilisés dans l’ingénierie de la sûreté et de la sécurité pour les appliquer à des formes de sécurité différentes. Au lieu de se demander : « Nos systèmes sont-ils fiables ? Sont-ils précis ? Fonctionnent-ils comme prévu ? Sont-ils adaptés à leur usage, de sorte qu’aucun être humain ne subisse de préjudice du fait des décisions ou des recommandations qu’ils génèrent ? » Au lieu de cela, nous nous retrouvons avec des cadres relatifs à la sécurité et à l’éthique qui portent sur des questions telles que l’autonomie, l’intentionnalité ou la conscience de ces systèmes. Or, il s’agit là d’une question tout à fait différente. Ces systèmes peuvent souvent donner l’illusion de posséder ces caractéristiques, ce qui conduit à anthropomorphiser le langage ou les actions de ces modèles. Nous avons vu récemment, par exemple, les capacités de cybersécurité être présentées comme si ces systèmes étaient autonomes – comme s’ils agissaient de leur propre chef, ce qui correspondrait à une attente que nous aurions à leur égard. Pourtant, dans la réalité, ces entreprises les déployaient dans des environnements très peu sécurisés et amenaient délibérément ces modèles à mener des cyberattaques dans le cadre de tests ou d’évaluations comparatives. »
« C’est précisément ce qui me pose problème : ces entreprises tentent, une fois de plus, d’attribuer la responsabilité à l’IA plutôt qu’à elles-mêmes. Or, l’IA ne fait que ce que nous lui ordonnons de faire ; elle n’est capable que de ce pour quoi nous l’avons conçue. »
« Il est donc crucial de garder à l’esprit que, certes, ces systèmes sont performants. Oui, ils sont capables de mener des actions telles que des cyberattaques ou des frappes. Et ils accélèrent effectivement les opérations ; c’est indéniable. C’est même l’une de leurs caractéristiques fondamentales. Toutefois, si l’on dispose d’un outil qui accélère les opérations mais dont la fiabilité et la précision de base se situent entre 30 et 60 %, le résultat ne diffère guère d’un ciblage aveugle, n’est-ce pas ? » Nous ne sommes pas confrontés à des robots tueurs dotés d’intentions propres, mais à une conception délibérée, défaillante, produite par des personnes qui « décident de le déployer, en toute connaissance de cause des systèmes à la fiabilité et à la précision médiocres – surtout dans des situations inédites, un cas de figure plus probable encore en temps de guerre que lors de cyberattaques.»